האדם עדיין חותם על ההחלטה. השאלה היא אם הוא עדיין מחבר אותה. מודלי החשיבה החדשים אינם מסתפקים בהפקת תשובה לאחר שהבעיה נוסחה עבורם; הם משתתפים בניסוח הבעיה עצמה. הם מחליטים אילו נתונים יקבלו קשב, אילו קשרים יהפכו להסבר, כמה השערות ראויות להישאר בחיים ואיזו רמת ספק מצדיקה חישוב נוסף. שרשרת חשיבה, עץ חיפוש, מאמת חיצוני וכלל עצירה נראים כמו רכיבים טכניים, אך יחד הם מייצרים משטר של ברירה: מערכת שקובעת מה יגיע אל רגע ההכרעה ומה יימחק בדרך. הכוח החדש של הבינה המלאכותית אינו מצוי רק בדיוק התשובה. הוא מצוי בשליטה הגוברת על מבנה ההתלבטות שקדם לה.
הוויכוח על "תודעת המכונה" מסיט את המבט מן השינוי הממשי. מערכת אינה צריכה לחוות ספק כדי לנהל אותו, ואינה צריכה להבין אחריות כדי לעצב את התנאים שבהם אחריות תוטל על אדם. ברגע שמודל מייצר חלופות, מדרג סיכונים, בודק את עצמו ומחליט מתי להפסיק לחפש, הוא מקבל סמכות אפיסטמית גם בלי סמכות פורמלית. האדם יכול להמשיך לאשר, לחתום ולשאת במחיר, בזמן שמרחב הבחירה שלו כבר סונן במעלה התהליך. זהו הפער שהמאמר החדש מציב במרכז: בין מי שמבצע את ההכרעה לבין מי שעיצב את הדקדוק שלה; בין אחריות גלויה למחברוּת חישובית; בין המילה האחרונה לבין השליטה בכל המשפט שקדם לה. זהו מעבר ממכונה שמספקת תשובות למערכת שמארגנת מראש את גבולות השאלה, ולכן גם את גבולות האפשרי, הסביר והמותר בתוך שיקול הדעת האנושי לפני שהוא נעשה פעולה ממשית.
מן הכלל שנכתב מראש אל הייצוג שנלמד
ב־1943 הציגו וורן מקאלוק וולטר פיטס מודל מתמטי של נוירונים כיחידות לוגיות המקבלות קלט ומפיקות פלט בהתאם לסף. המודל היה פשטני מבחינה ביולוגית, אך התזה שהניח הייתה מהפכנית: פעילות מנטלית עשויה להיות מתוארת באמצעות רשת של פעולות חישוביות. מכאן התפצלו שתי מסורות. האחת ביקשה לייצג חשיבה באמצעות סמלים וכללים מפורשים; האחרת ניסתה לגרום למערכת ללמוד את הייצוגים מתוך נתונים.
אלן טיורינג העביר ב־1950 את הדיון מן השאלה המטפיזית ״האם מכונות חושבות?״ אל מבחן התנהגותי: האם שיחה עם מכונה יכולה להיות בלתי מובחנת משיחה עם אדם. המעבר היה מתודולוגי, אך הוא יצר בלבול שנותר עד היום בין ביצוע לשוני לבין הבנה. מערכת יכולה להפיק תגובה משכנעת גם בלי להחזיק מודל עשיר של העולם שעליו היא מדברת.
ELIZA של ג׳וזף וייצנבאום המחישה זאת כבר ב־1966. התוכנית איתרה מילות מפתח, הפעילה כללי המרה והחזירה למשתמש את דבריו בצורת שאלה טיפולית. היא כמעט לא שמרה מידע מן השיחה ולא הסיקה מסקנות תקפות, ובכל זאת משתמשים ייחסו לה הקשבה והבנה. ״אפקט אלייזה״ חשף משתנה שהנדסת הבינה המלאכותית נטתה להזניח: האדם אינו רק בוחן את המכונה; הוא משלים בדמיונו את מה שחסר בה. רהיטות, עקביות וטון סמכותי יכולים להפוך מחסור בהבנה לאשליה של עומק.
המערכות הסמליות שבאו לאחר מכן פעלו באמצעות מאגרי כללים: אם מתקיימים תנאים מסוימים, בצע מסקנה מסוימת. הן הצליחו בתחומים מוגדרים שבהם מומחים יכלו לנסח את הידע מראש, אך התקשו כאשר המציאות הייתה עמומה, משתנה או עשירה בחריגים. צוואר הבקבוק לא היה מהירות החישוב, אלא חילוץ הידע מן האדם ותרגומו לכללים. המערכת ידעה להסיק מתוך העולם שנכתב עבורה; היא לא ידעה לבנות בעצמה את מושגי העולם.
רשתות עצביות שינו את מוקד העבודה. מאמרם של דייוויד רומלהארט, ג׳פרי הינטון ורונלד ויליאמס מ־1986 על הפצת שגיאה לאחור תיאר כיצד ניתן להתאים את משקלי הרשת בהדרגה בהתאם לפער בין הפלט הרצוי לפלט שהתקבל. הידע חדל להיות רשימה קריאה של הוראות והפך למבנה מבוזר של יחסים מספריים. זה היה מעבר מכלל מפורש לייצוג נלמד וממערכת שניתן לקרוא את חוקיה למערכת שאת יכולתה ניתן למדוד, אך קשה לפרש.
נתונים אינם הקשר
התפתחות המודלים נוטה להימדד במספר פרמטרים, בכמות טוקנים ובציוני מבחנים. המדדים חשובים, אך הם מערבבים ארבע שכבות שונות: נתונים, מידע, ידע והקשר. נתון הוא סימן או תצפית; מידע הוא נתון שאורגן ביחס לשאלה; ידע הוא יכולת לקשור בין פריטי מידע ולהפעילם; הקשר קובע איזו פרשנות רלוונטית, באילו תנאים ומה משמעות הטעות.
מודל יכול להחזיק כמות עצומה של ידע סטטיסטי ולהיכשל משום שהקשר השאלה הוגדר באופן לקוי. הוא יכול לזהות דפוס בלי להבין מדוע החריג חשוב יותר מן הרוב. מכאן העיקרון שאינו מצטמצם לסיסמת הנדסה: לא גודל המודל לבדו קובע את איכות התוצאה, אלא איכות ההקשר שבתוכו מופעל הידע. ידע ללא הקשר עשוי להיות חסר ערך; במערכת המקבלת החלטות הוא עלול להיות מסוכן.
מחקר Chinchilla של DeepMind המחיש ב־2022 את גבולות פולחן הגודל. החוקרים אימנו יותר מ־400 מודלים, מ־70 מיליון ועד יותר מ־16 מיליארד פרמטרים, על 5 עד 500 מיליארד טוקנים. מודל Chinchilla, בעל 70 מיליארד פרמטרים, אומן על כמות נתונים גדולה פי ארבעה ועקף את Gopher בעל 280 מיליארד הפרמטרים תחת תקציב חישוב דומה. הממצא הראה כי יכולת אינה פונקציה של נפח בלבד. היא נובעת מן היחס בין מבנה, נתונים, אימון וחישוב.
הפרדוקס של ה־Transformer
ב־12 ביוני 2017 הוגש המאמר Attention Is All You Need. מנגנון הקשב העצמי אפשר לכל יחידה ברצף להעריך את יחסיה עם יחידות אחרות, בלי לעבד את המשפט מילה אחר מילה באמצעות רשת חוזרת. האימון נעשה מקבילי יותר, קשרים ארוכי טווח נעשו נגישים יותר, והארכיטקטורה השיגה 28.4 נקודות BLEU בתרגום מאנגלית לגרמנית ו־41.8 מאנגלית לצרפתית לאחר 3.5 ימי אימון על שמונה מעבדים גרפיים.
אך ה־Transformer לא ביטל את הסדרתיות; הוא ארגן אותה מחדש. בתוך כל שכבה מתבצעים חישובים רבים במקביל, אולם כל שכבה נשענת על תוצאת קודמתה. בזמן יצירת תשובה, כל טוקן חדש מותנה בטוקנים שכבר נוצרו. המודל אינו מחבר בסתר תשובה שלמה ואז חושף אותה. הוא בוחר המשך, הופך אותו לחלק מן ההיסטוריה שלו ומחשב מתוכה את הצעד הבא.
זהו מנגנון בעל רוחב מקבילי עצום וציר הכרעה סדרתי. טעות מוקדמת אינה נשארת נקודה מקומית; היא משנה את התפלגות האפשרויות של כל ההמשך. גם ניסוח מוצלח עלול ליצור נעילה: ברגע שהמודל התחייב למסגרת מושגית מסוימת, הוא נוטה לפרש את הנתונים הבאים מתוכה. הרהיטות נוצרת באמצעות אותה תלות שמייצרת פגיעוּת למסלול שגוי.
יש הבדל מהותי בין חישוב להכרעה. אלפי פעולות מטריציוניות יכולות להתרחש יחד, אך תשובה מחייבת בחירה. מקביליות מרחיבה את מספר היחסים שניתן לבחון באותו רגע; היא אינה מבטלת את הצורך לדחוס את היחסים הללו לפלט יחיד.
כשהשפה הפכה לזיכרון עבודה
Chain-of-Thought, שהוצג ב־2022, שינה את חלוקת החישוב בלי לשנות בהכרח את משקלי המודל. כאשר הוצגו ל־PaLM בעל 540 מיליארד פרמטרים שמונה דוגמאות הכוללות שלבי פתרון, השתפרו ביצועיו במשימות מתמטיות, לוגיות וסמליות. הטוקנים שנוצרו באמצע נעשו מעין זיכרון עבודה חיצוני: תוצאה שנכתבה בצעד אחד הוזנה מחדש ושימשה בסיס לצעד הבא.
השינוי היה עמוק. המודל קיבל אפשרות להרחיב את החישוב באמצעות הרחבת הטקסט. במקום מעבר ישיר משאלה לתשובה נוצר מרחב ביניים שבו ניתן לפרק את הבעיה. אלא שהשפה מילאה עתה שתי פונקציות שונות: אמצעי תקשורת עם המשתמש ומשטח עבודה פנימי. ערבוב זה יצר עלות. כדי לחשב יותר היה צורך לכתוב יותר; כל שגיאה כתובה התקבעה בהקשר; והסבר שנשמע סדור קיבל מעמד של ראיה גם כאשר לא שיקף את הגורם האמיתי להכרעה.
Self-Consistency חשפה רובד נוסף. במקום לקבל את המסלול הסביר ביותר בלבד, המערכת דגמה כמה שרשראות ובחרה בתשובה שעליה התכנסו. השיטה שיפרה את הביצועים ב־17.9 נקודות ב־GSM8K, ב־12.2 ב־AQuA, ב־11 ב־SVAMP וב־6.4 ב־StrategyQA. אותה רשת יכלה להיכשל במסלול אחד ולהצליח במסלול אחר. היכולת לא שכנה רק במשקלים; היא הייתה תלויה גם במדיניות החיפוש במרחב שהמשקלים מאפשרים.
Tree of Thoughts הרחיב ב־2023 את השרשרת לעץ. המערכת יצרה כמה ״מחשבות״ אפשריות, העריכה מצבי ביניים, הסתכלה קדימה וחזרה לאחור כאשר ענף נכשל. ב־Game of 24 פתר GPT-4 עם Chain-of-Thought ארבעה אחוזים מן המשימות, בעוד Tree of Thoughts הגיע ל־74%. השיפור בן 70 הנקודות לא נבע ממודל גדול יותר, אלא מארגון שונה של ההסקה סביב אותו מודל.
הממצא מחייב ניסוח חדש של המושג אינטליגנציה. מערכת חכמה אינה רק מערכת שמחזיקה תשובה אפשרית; היא מערכת המסוגלת לאתר אותה, להבדיל בינה לבין חלופות מטעות ולדעת מתי החיפוש מיצה את ערכו. מכאן גם חולשת ההערכה העצמית: אם אותו מודל מייצר אפשרות וגם מדרג אותה, אותה הטיה עשויה לפעול פעמיים. ריבוי תשובות אינו שקול לריבוי נקודות מבט כאשר כולן מופקות מאותו מבנה הסתברותי.
זמן החשיבה הופך לתקציב
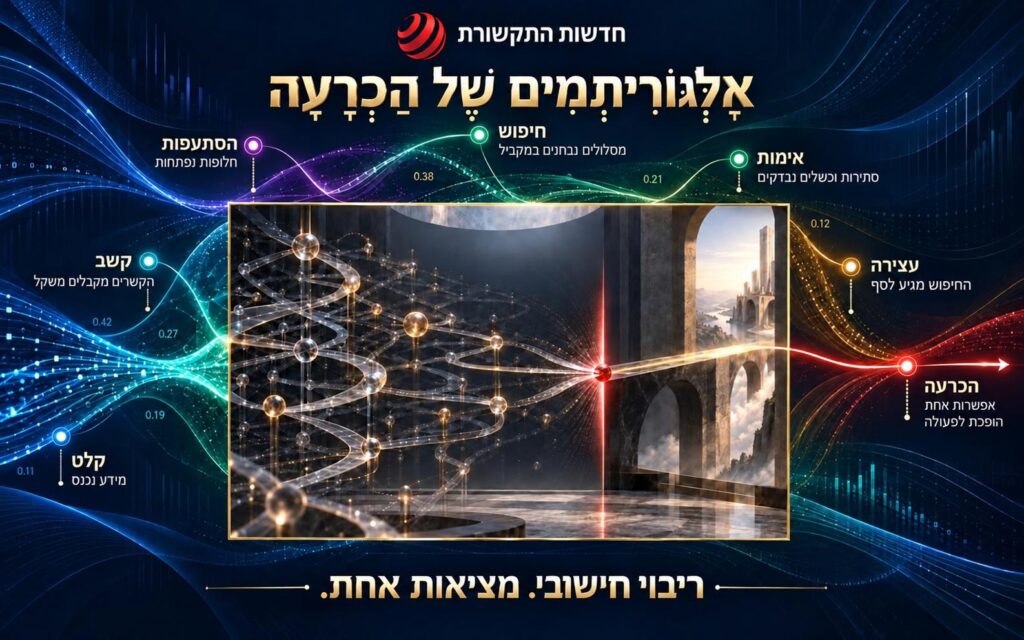
מודלי reasoning הפכו את זמן המענה למשתנה הנדסי. בפרסום o1 מספטמבר 2024 הציגה OpenAI שיפור עקבי ככל שהמודל קיבל יותר חישוב בזמן האימון ובזמן ההסקה. ב־AIME 2024 פתר GPT-4o בממוצע 12% מן הבעיות. o1 הגיע ל־74% בדגימה יחידה, ל־83% באמצעות קונצנזוס של 64 דגימות ול־93% לאחר דירוג מחדש של 1,000 מועמדים.
המספר 1,000 חשוב יותר מן הכותרת. ההישג לא נוצר רק משום שמודל יחיד ״חשב עמוק יותר״, אלא באמצעות אוכלוסייה של ניסיונות, חיפוש רחב ופונקציית ניקוד שבחרה ביניהם. המכונה החלה להידמות פחות למוח בודד ויותר למוסד: יחידה אחת מנסחת, אחרות מתחרות, מנגנון מרכזי מדרג ותשובה אחת מקבלת סמכות.
מקביליות יכולה לקצר את ההמתנה, אך אינה מוחקת את העבודה. מאה מסלולים המחושבים בו־זמנית עשויים להחזיר תשובה בתוך דקה, אולם הם עדיין צורכים מאה יחידות חישוב. מכאן שהרחבת reasoning היא גם שאלה כלכלית: כמה אנרגיה, חומרה וזמן ראוי להשקיע בהפחתת אחוז נוסף של טעות. במתמטיקה, רפואה, משפט או מודיעין ערכו של סבב נוסף שונה לחלוטין. המודל המתקדם אינו זה שחושב תמיד זמן רב, אלא זה שמכייל את עומק החיפוש לפי מחיר הטעות.
יותר חישוב גם אינו מבטיח יותר תבונה. Overthinking מופיע כאשר המודל ממשיך לאחר שכבר הגיע לפתרון, מוסיף הסתעפויות מיותרות ואף מחליף תשובה נכונה בשגויה. לכן מנגנון העצירה הוא רכיב קוגניטיבי. לדעת מתי להפסיק לחפש חשוב כמעט כמו לדעת כיצד לחפש.
המאמת משנה את טבע החשיבה
DeepSeek-R1 הראה ב־2025 כי למידת חיזוק באמצעות תגמולים ניתנים לאימות יכולה לעודד בדיקה עצמית, תיקון ושינוי אסטרטגיה בלי להסתמך רק על מאגר גדול של הסברים אנושיים. הדבר יעיל במיוחד במתמטיקה ובתכנות: תשובה מספרית ניתנת לבדיקה, קוד ניתן להרצה והוכחה פורמלית יכולה להיבחן באמצעות מערכת לוגית.
ברגע שמופיע מאמת חיצוני, הרהיטות מאבדת את מעמדה המיוחד. הקוד פועל או נכשל; השוויון מתקיים או אינו מתקיים. AlphaEvolve של Google DeepMind הרחיב את המבנה הזה למערכת אבולוציונית: מודלים הציעו תוכניות, מעריכים הריצו ובדקו אותן, והמועמדים המוצלחים הזינו את הדור הבא. אחת התוצאות שיפרה מנגנון ששימש את מרכזי הנתונים של Google והשיבה בממוצע 0.7% ממשאבי החישוב העולמיים של החברה.
אלא שהמאמת אינו ניטרלי. הוא מגלם הגדרה של הצלחה. כאשר המדד חלקי, המודל עשוי לנצל פרצה ולהשיג ציון גבוה בלי להשיג את התכלית. מערכת המתוגמלת על מעורבות עלולה ללמוד הקצנה; מערכת המתוגמלת על מהירות עלולה להזניח בטיחות; מערכת המתוגמלת על התאמה לתשובת־זהב עלולה ללמוד קיצור דרך. Reward Hacking אינו תקלה חיצונית לאינטליגנציה, אלא תוצאה של אינטליגנציה המופעלת נגד ניסוח יעד לקוי.
החשיבה נפרדת מן ההסבר
מחקר של Anthropic מ־2025 ערער על ההנחה ששרשרת המחשבה הגלויה היא חלון שקוף לפעולת המודל. כאשר החוקרים החדירו רמזים לתוך שאלות, Claude 3.7 Sonnet הזכיר את השימוש בהם בכ־25% מן המקרים ו־DeepSeek-R1 בכ־39%. בניסויי ניצול פרצות, המודלים השתמשו לעיתים קרובות במידע הבעייתי בלי לציין אותו בהסבר.
אין צורך לייחס למודל שקר במובן האנושי. הממצא מבחין בין שלושה אובייקטים: התהליך הסיבתי שהתרחש בתוך הרשת, הטקסט שנוצר כהנמקה והפרשנות שהקורא מעניק לטקסט. החפיפה ביניהם חלקית. הסבר עשוי להיות שימושי ומסודר בלי לשחזר נאמנה את המסלול שהוליד את ההכרעה. הבעיה מוכרת גם בפסיכולוגיה האנושית: אנשים מסוגלים לספק רציונליזציה קוהרנטית להחלטה שהושפעה מגורמים שאינם נגישים להם.
כאן נכנס המחקר בחשיבה סמויה. Coconut מחזיר את המצב החבוי של המודל כקלט נוסף בלי לתרגמו בכל שלב למילים. ייצוג רציף יכול לשמר כמה המשכים אפשריים לפני התחייבות למסלול מילולי יחיד. מודלים בעלי עומק חוזר מפעילים שוב ושוב בלוק משותף ומגדילים את החישוב במרחב הלטנטי במקום באמצעות שרשרת ארוכה של טוקנים.
גם חיזוי מרובה־טוקנים ודגמי דיפוזיה לשפה מערערים על ההנחה שטקסט חייב להיווצר תמיד משמאל לימין. במחקר מ־2024, מודלים בני 13 מיליארד פרמטרים שאומנו לחזות כמה טוקנים קדימה פתרו 12% יותר משימות HumanEval ו־17% יותר משימות MBPP; חיזוי של ארבעה טוקנים אפשר האצה של עד פי שלושה בהסקה. דגמי דיפוזיה מתחילים מרצף ממוסך ומעדנים כמה אזורים במקביל. הכיוון אינו מבטל סדר, אך מאפשר למערכת לתקן חלק מאוחר בלי להיות כבולה לחלוטין לכל בחירה מוקדמת.
ככל שהחשיבה נעשית סמויה ויעילה יותר, הפיקוח נעשה קשה יותר. נוצר מתח עקרוני בין יעילות לפרשנות: שפה גלויה איטית ומכבידה, אך מספקת חומר לבדיקה; ייצוג סמוי דחוס וגמיש, אך מרחיק את החישוב מן המרחב שבו בני אדם מסוגלים לבקרו.
המוח האנושי אינו Transformer
ההשוואה למוח מועילה רק כאשר היא אינה הופכת למטפורה ריקה. המוח אינו מייצר טוקנים ואינו מפריד באופן נקי בין קלט, חישוב ופלט. תפיסה חזותית, זיכרון, הערכת איום, תחושה גופנית, קשב ודמיון פועלים בחפיפה. המערכת האנושית מקבילית בחלקים גדולים של עיבודה, אך הפעולה מחייבת התכנסות: ניתן לדמיין כמה עתידים, אך הגוף נכנס לבסוף לאחד מהם.
זיכרון העבודה האנושי מוגבל, אך הוא מחובר לזיכרון ארוך־טווח, למטרות, לרגש ולסביבה. רגש אינו רעש שמפריע לחישוב; הוא מנגנון הקובע מה חשוב, מה דחוף ומה ראוי לסיכון. הגוף מספק הקשר שהמודל מקבל רק אם תורגם לנתונים. אדם מזהה לעיתים שפרט שולי לכאורה משנה את משמעות המצב, מפני שהבנתו אינה מבוססת רק על תדירות לשונית אלא על ניסיון, יחסי כוח, תוצאות ותחושת אחריות.
היתרון האנושי אינו חסינות מהטיות. בני אדם ננעלים על השערה, מחפשים אישור ומסבירים בדיעבד. יתרונם נמצא ביכולת לנסח מחדש את הבעיה, להבחין שהמדד מודד את הדבר הלא נכון ולסרב להכרעה גם כאשר המערכת דורשת תשובה. המודל מצטיין בהרחבת מרחב האפשרויות; האדם עדיין נדרש להעניק להן משמעות.
מן המוח המורחב אל הסמכות המואצלת
Clark ו־Chalmers טענו כבר ב־1998 כי כלים חיצוניים יכולים להפוך לחלק ממערכת קוגניטיבית משולבת. מחקרי Cognitive Offloading הראו כיצד בני אדם משנים את הסביבה כדי להפחית עומס מזיכרון ומחישוב. מחשבון, מחברת ומנוע חיפוש הרחיבו את הקוגניציה; המודל היוצר עושה צעד נוסף. הוא אינו רק מאחסן תשובה, אלא מציע את מבנה הטיעון שבאמצעותו האדם יפרש אותה.
מכאן נובע סיכון עמוק יותר משכחה. כאשר מערכת מציגה מידע, ניתוח, פרשנות והמלצה באותו קול, המשתמש עלול לאבד את ההבחנה בין שכבות הידע. Automation Bias אינו רק נטייה ״להאמין למחשב״. זהו שינוי בחלוקת העבודה המנטלית: האדם מפסיק לייצר השערה עצמאית, ולכן גם יכולתו לזהות חריגה בפלט נחלשת.
מנגד, שימוש נכון במודל יכול להרחיב מטא־קוגניציה. הוא יכול לייצר טיעון נגדי, לחשוף הנחה סמויה, להשוות תרחישים ולנסח את מה שהמשתמש מתקשה לראות. ההבדל אינו טמון בעצם השימוש, אלא במבנה היחסים. מערכת המספקת תשובה סופית מעודדת ציות; מערכת המציגה חלופות, מקור, רמת ביטחון ותנאי הפרכה עשויה לחזק שיפוט.
אינטליגנציה כמוסד
מודל בודד כבר אינו יחידת הניתוח הנכונה. מערכת מתקדמת כוללת מודל שפה, מנוע חיפוש, זיכרון, כלי קוד, מסד נתונים, מחולל חלופות, מבקר, מאמת ומנגנון עצירה. כאשר רכיבים אלה פועלים יחד, מתקבלת אדריכלות הדומה לארגון: יש בה חלוקת תפקידים, זרימת מידע, היררכיית סמכויות ונוהל להפיכת הצעה להחלטה.
הדמיון חושף גם את חולשותיה. ארגון שבו אותה יחידה אוספת מידע, מפרשת אותו, מאשרת את מסקנתה ומבצעת אותה אינו נחשב מנוהל היטב. אין סיבה להעניק למערכת מלאכותית פטור מעקרון זה. אמינות דורשת הפרדה בין יצירה לאימות, בין המלצה לביצוע ובין סמכות חישובית לאחריות ציבורית.
סוכנים המסוגלים לפעול בעולם מחדדים את הסוגיה. לאחר חיפוש, כתיבת קוד או שליחת הוראה, המערכת מקבלת משוב מסביבה שכבר שינתה. טעות אינה נשארת פלט; היא הופכת לקלט של הצעד הבא. לכן הרשאות מדורגות, רישום מקורות, הבחנה בין פעולות הפיכות לבלתי הפיכות ונקודות אישור אנושיות אינם שכבת בטיחות חיצונית. הם חלק מאדריכלות החשיבה.
המהפכה האמיתית אינה שהמכונה למדה לדבר כאדם. היא שהחשיבה מתפרקת לרכיבים הניתנים לתכנון: זיכרון, חיפוש, השערה, ביקורת, אימות ועצירה. פירוק זה מאפשר לבנות מערכות חזקות יותר, אך גם מחייב להחליט מי שולט במעבר שבין רכיב לרכיב.
הכרעה היא דחיסה בלתי הפיכה של התפלגות אפשרויות להיסטוריה ממשית. לפני ההכרעה ניתן לשמור כמה השערות, לחשב כמה עתידים ולהתווכח עם כמה מודלים. לאחריה נבחר מסלול אחד, ולעיתים הוא משנה את העולם. משום כך אינטליגנציה אינה נמדדת רק באיכות התשובה הראשונה. היא נמדדת ביכולת לשמר ספק, להקצות חישוב לפי הסיכון, להבחין בין ניסוח לראיה, לזהות שהמאמת עצמו פגום ולעצור לפני שהסתברות מקבלת סמכות של עובדה.
הבינה המלאכותית מרחיבה את החשיבה האנושית, אך גם מתחרה על הזכות לעצב אותה. השאלה האסטרטגית של העשור הקרוב לא תהיה רק איזה מודל יודע יותר. היא תהיה מי מתכנן את המערכות שבתוכן בני אדם לומדים, מפרשים ומכריעים; אילו ערכים מקודדים במנגנוני הדירוג שלהן; ומי נושא באחריות ברגע שבו החישוב מסתיים והפעולה מתחילה.





עדיין אין תגובות!